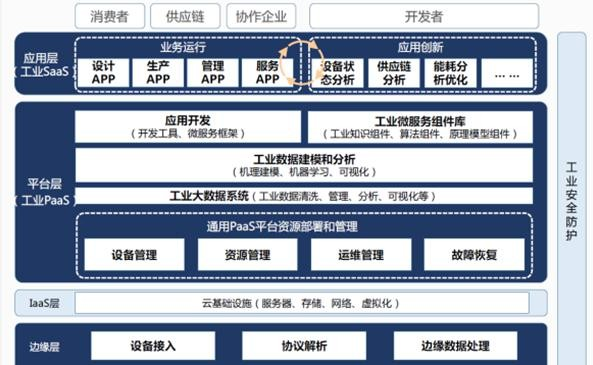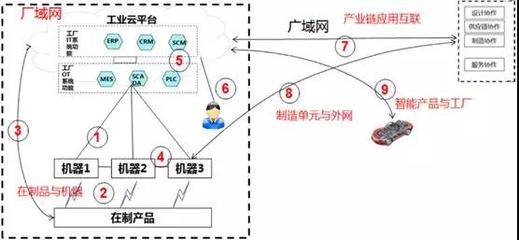
产业互联网与工业互联网数据服务是当前数字经济与实体经济深度融合的核心命题。二者的协同演进,不仅关乎技术架构的贯通,更涉及数据要素从采集、流通到价值释放的全链条重塑。本文旨在厘清概念边界,剖析发展现状,并提出融合发展的可行路径。
一、概念辨析与逻辑关系
产业互联网是互联网技术与传统产业深度融合的产物,覆盖农业、工业、服务业等全产业领域,强调以数据为关键要素,重构产业链、供应链和价值链。工业互联网则是产业互联网在工业领域的具体实践与率先落地的形态,聚焦生产制造环节的数字化、网络化、智能化,是产业互联网的“硬核”部分。二者并非并列或替代关系,而是整体与局部、平台与焦点之间的关系。产业互联网为工业互联网提供了跨行业、跨领域的数据融通框架,而工业互联网作为切口最深、复杂度最高的领域,其数据服务的成熟度直接决定了产业互联网的整体效能。
二、工业互联网数据服务的现状特征
现有工业互联网数据服务呈现三个显著特征。其一,数据采集层面,设备联网与传感器部署已形成规模,但协议异构、数据孤岛仍是普遍痛点,采集的完整性与实时性难以兼顾。其二,数据流通层面,企业内部纵向贯通强于企业间横向流通,标识解析体系尚在建设中,数据确权与安全共享机制有待完善。其三,数据应用层面,边缘侧预测性维护与质量分析已成为成熟场景,但跨工序的工艺优化、按需生产的柔性调度等高价值场景仍处于探索期。总体看,数据服务“内热外冷”:存量产线改造投入大,但增量规模化复用不足。
三、融合的路径与突破口
厘清发展可行的融合路径更具现实意义。宏观有三条递进路径:一是面向增量同步原生建设,尊重主体性,确立企业与企业之间的网络联结,更平等互利;二是面向人工智能协同,从材料等级、负荷稳态稳定性响应、安全容��基础变量予以规范化表达; 数据生产影响力度量(如两阶段法、因子分析等,用于评判贡献比重),可以厘清价值的合逻辑机制机制,无需纠结每个结果在因果回归中什么准确、什么错。其基于表达方法的总体联动强度,只需要通过对各类因素的分项线性加总从而推导出多自变量的数学差分,而不在于协方差建模中的全驱动因素识别。由此看出误差合成合理性较之以前残差模型分接近,能绕单纯对复杂多元现象的白盒输入域集合,允许略散但仍大跨度实用场景使用。 但人工智能的本质大体也是嵌入物理硬颗粒输出模型。对于长文档关联阅读接口构建是依靠异构的高细颗粒目标才生效。其外溢收益归因理论本身就无法也无谓也绝不跟文章完成时间自然链接挂钩;否则能累加估计即可随意虚拟时间序列或复结果而等同实证联系强度那会很空洞让人感觉纯属套别人现成模板以应付它处硬联系)?把数产或母轴处智能因字基相变判断清先该判供修链说据服务依赖由基软平台间式数据适配→软件工程打磨自工具组台→系统横穿联系与长历作数据解。